Dlaczego firmy w 2026 roku przerzucają się z OCR na LLM
Automatyzacja PDF do JSON polega na zamianie treści dokumentu na pola, które można przekazać do systemu lub arkusza. Proces ma 2 odrębne zadania: odczyt danych oraz sprawdzenie ich zgodności ze schematem i dokumentem źródłowym. OCR i modele językowe mogą wspierać odczyt, ale koszt oraz skuteczność trzeba zmierzyć na własnych dokumentach.
W tym przewodniku pokażemy krok po kroku, jak zamienić dowolny plik PDF na czysty, ustrukturyzowany JSON przy użyciu nowoczesnych modeli AI. Porównamy klasyczny OCR (Tesseract, AWS Textract, Google Document AI) z podejściem opartym na LLM (GPT-4o, Gemini 3, Claude Opus 4) i pokażemy gotowe schematy wdrożeń dla działów księgowości, prawnych oraz operacyjnych.
PDF to JSON — na czym polega problem
PDF to format prezentacji, nie danych. Tekst w PDF nie ma struktury logicznej: nagłówki, tabele, pola formularza i metadane są zakodowane jako współrzędne wizualne. Kiedy próbujesz wyciągnąć kwotę netto z faktury, musisz zrozumieć:
- gdzie kończy się tabela pozycji, a zaczyna stopka,
- czy „Razem" odnosi się do brutto, netto, czy do podsumowania pojedynczej kategorii,
- jaki format daty zastosował dostawca,
- czy NIP jest zapisany z myślnikami, spacjami, czy bez separatorów.
Klasyczny OCR rozwiązuje pierwszy etap — przepisuje obraz na tekst. Drugi etap, czyli zrozumienie semantyki dokumentu, dopiero dziś staje się dostępny dzięki LLM.
OCR vs LLM — porównanie podejść
Klasyczny OCR (Tesseract, AWS Textract, Google Document AI)
Plusy: Niski koszt jednostkowy (od 0,001 USD za stronę), bardzo dobra dokładność na czystych skanach, działa offline (Tesseract), przewidywalne czasy odpowiedzi.
Minusy: Wymaga zdefiniowanych szablonów dla każdego dostawcy, źle radzi sobie z dokumentami o zmiennym układzie, nie rozumie kontekstu (np. że „PLN" i „zł" to ta sama waluta), potrzebuje osobnej warstwy reguł biznesowych.
LLM (GPT-4o, Gemini 3, Claude Opus 4)
Plusy: Rozumie kontekst i synonimy, działa na dowolnym układzie dokumentu bez szablonów, potrafi wnioskować (np. obliczyć VAT, jeżeli go brak), zwraca gotowy JSON zgodny ze schematem, radzi sobie z dokumentami wielojęzycznymi.
Minusy: Wyższy koszt (0,01–0,05 USD za stronę), dłuższy czas odpowiedzi (1–5 s na stronę), wymaga walidacji wyników i monitoringu jakości.
Podejście hybrydowe — rekomendacja na 2026
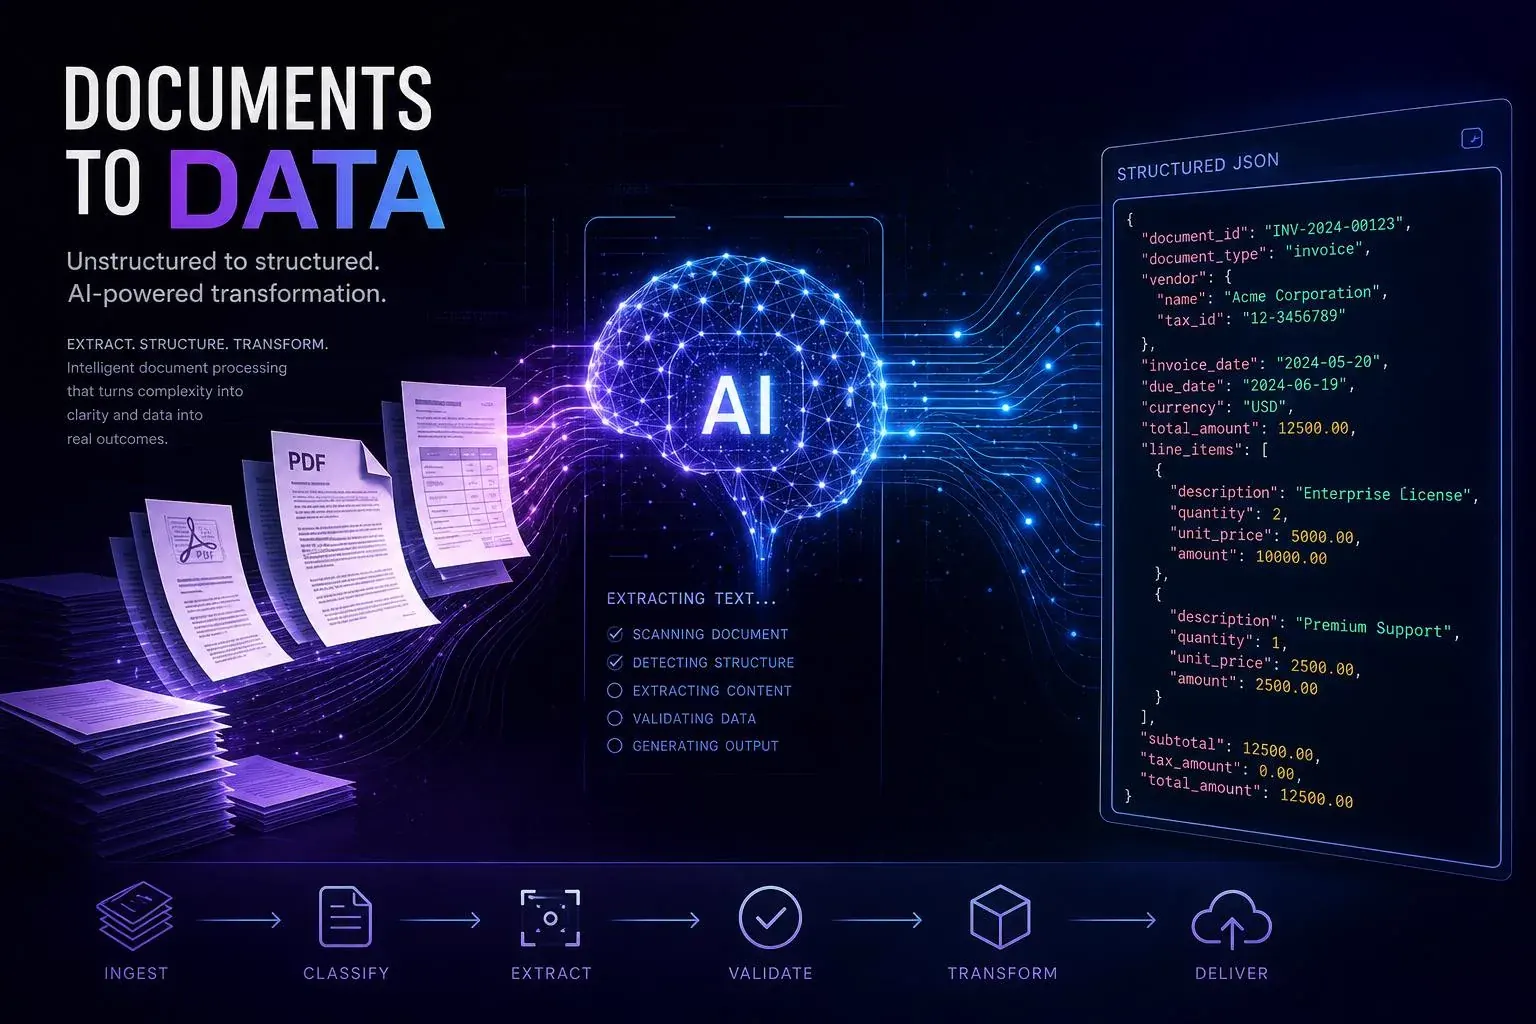
W produkcji najlepsze wyniki daje pipeline hybrydowy: OCR + LLM + walidacja regułowa. OCR ekstraktuje surowy tekst (taniej i szybciej niż wysyłanie obrazów do modelu), LLM nadaje mu strukturę i mapuje na JSON, a warstwa reguł sprawdza poprawność (NIP, suma kontrolna IBAN, zgodność netto + VAT = brutto).
Architektura pipeline'u PDF → JSON
1. Ingestion (e-mail, S3, SharePoint, webhook)
   ↓
2. Pre-processing (deskew, denoise, podział na strony)
   ↓
3. OCR layer (Tesseract / Textract / Document AI)
   ↓
4. LLM extraction (GPT-4o / Gemini 3 z JSON Schema)
   ↓
5. Validation (regex, checksum, reguły biznesowe)
   ↓
6. Human-in-the-loop (kolejka do akceptacji, jeśli confidence < 95%)
   ↓
7. Delivery (ERP / CRM / Webhook / Google Sheets)
Praktyczny przykład: faktura kosztowa → JSON
Załóżmy, że chcemy z faktury PDF wyciągnąć: numer, datę wystawienia, datę płatności, dane sprzedawcy, NIP, pozycje, kwoty netto, VAT, brutto oraz numer konta.
Krok 1: Zdefiniuj schemat JSON
{
  "invoice_number": "string",
  "issue_date": "YYYY-MM-DD",
  "due_date": "YYYY-MM-DD",
  "seller": { "name": "string", "nip": "string", "address": "string" },
  "buyer": { "name": "string", "nip": "string" },
  "items": [{ "name": "string", "qty": "number", "unit_price": "number", "vat_rate": "number", "net": "number", "gross": "number" }],
  "totals": { "net": "number", "vat": "number", "gross": "number" },
  "bank_account": "string",
  "currency": "string"
}
Krok 2: Wywołaj model z trybem structured outputs
Modele OpenAI, Google i Anthropic obsługują tryb JSON Mode / Structured Outputs, który gwarantuje, że odpowiedź będzie zgodna ze schematem. Przykładowy prompt:
"Jesteś ekspertem księgowym. Z poniższego tekstu faktury wyodrębnij dane
zgodnie z dostarczonym schematem JSON. Daty zwróć w formacie ISO,
kwoty jako liczby (kropka jako separator dziesiętny), NIP bez separatorów.
Jeśli pole nie występuje, użyj null. Nie zgaduj wartości."
Krok 3: Walidacja
- NIP — sprawdź sumę kontrolną (algorytm wagowy 6-5-7-2-3-4-5-6-7).
- IBAN — walidacja mod 97.
- Sumy — netto + VAT = brutto (±0,01 zł).
- Daty — due_date ≥ issue_date.
Narzędzia, które warto znać w 2026
- n8n + GPT-4o / Gemini — najpopularniejszy stack low-code do IDP w polskich firmach. Integruje pocztę, OCR i ERP w jednym workflow.
- LlamaParse — wyspecjalizowany parser PDF z natywną obsługą tabel i wykresów.
- Unstructured.io — open source, świetny do dużych wolumenów i RAG.
- Google Document AI — gotowe procesory dla faktur, paragonów i dokumentów tożsamości.
- Reducto, Mindee, Rossum — komercyjne platformy IDP z API.
- Hermes Agent (open source) — polskie rozwiązanie do prywatnych wdrożeń on-premise.
Ile to kosztuje w praktyce
Dla typowego polskiego MŚP przetwarzającego 500 faktur miesięcznie:
- Ręczne przepisywanie: ok. 1 500–3 000 zł / mies. + błędy.
- OCR (Textract) + reguły: ok. 100 zł / mies., ale wymaga programisty do utrzymania szablonów.
- Pipeline LLM (Gemini 3 Flash + walidacja): ok. 80–150 zł / mies., bez szablonów, działa na dowolnym dostawcy.
Zwrot z inwestycji we wdrożenie (zwykle 8–25 tys. zł) następuje w 2–4 miesiące, a jakość danych w ERP rośnie z ~93% do 99%+.
Najczęstsze błędy przy wdrożeniu
- Brak walidacji — LLM potrafi „halucynować" wartości. Zawsze waliduj NIP, IBAN i sumy.
- Wysyłanie całych skanów do drogich modeli — najpierw OCR, dopiero potem LLM na czystym tekście.
- Brak human-in-the-loop — dla pól krytycznych (kwoty, numery kont) zostaw próg confidence i kolejkę akceptacji.
- Ignorowanie RODO — dla danych osobowych wybieraj modele w UE (Mistral, Gemini EU) lub on-premise.
- Brak monitoringu — loguj wyniki, mierz dokładność per dostawca, dotrenowuj prompt.
Podsumowanie
Automatyzacja przepływu PDF → JSON to dziś jedna z najbardziej opłacalnych ścieżek wdrożenia AI w polskich firmach. Nowoczesne LLM razem z klasycznym OCR pozwalają zbudować pipeline, który działa na dowolnym dokumencie bez szablonów, zwraca czyste dane do ERP i zwraca się w kilka miesięcy.
Jeśli chcesz wdrożyć taki system w swojej firmie — napisz do nas lub sprawdź naszych agentów AI i usługi wdrożeniowe.